TypeSafe AIが2026年9月15日に公開した「Jev」というモデルを最初に見たとき、僕は料金欄で手が止まりました。入力100万トークンあたり0.042ドル、出力は無料。桁を見間違えたかと思って公式ドキュメントを開き直したくらいです。
Jevは文章を書きません。「この問い合わせはどの部署か」「この申請は承認していいか」といった判断だけを、型の決まった値で返します。僕はClaude Codeを毎日使ってVibelyという自社SaaSを開発・運営していて、AIをどこまでプロダクトに組み込むかを日々考えている立場なので、他人事ではありませんでした。
この記事では、Jevが何をするモデルなのかを公式の数字で整理した上で、いま試す経路と、Jevを使わなくても今日から効く「分解して聞く」設計まで書きます。内容は2026年9月18日時点の公式発表・公式ドキュメントと報道に基づきます。
Jevとは — 2026年9月15日公開の「System One モデル」
発表したのは米サンフランシスコのTypeSafe AI。創業者のDiogo Almeida氏はInfoWorldで「元OpenAIの研究者でRLHFの共同発明者」と紹介されています。公式ブログの書き出しは「モデルは何年も前からチャットでは超人的なのに、自動化はどこへ行ったのか」。2年のステルス期間を経た最初の公開モデルです。
文章ではなく「型の決まった判断」を返す
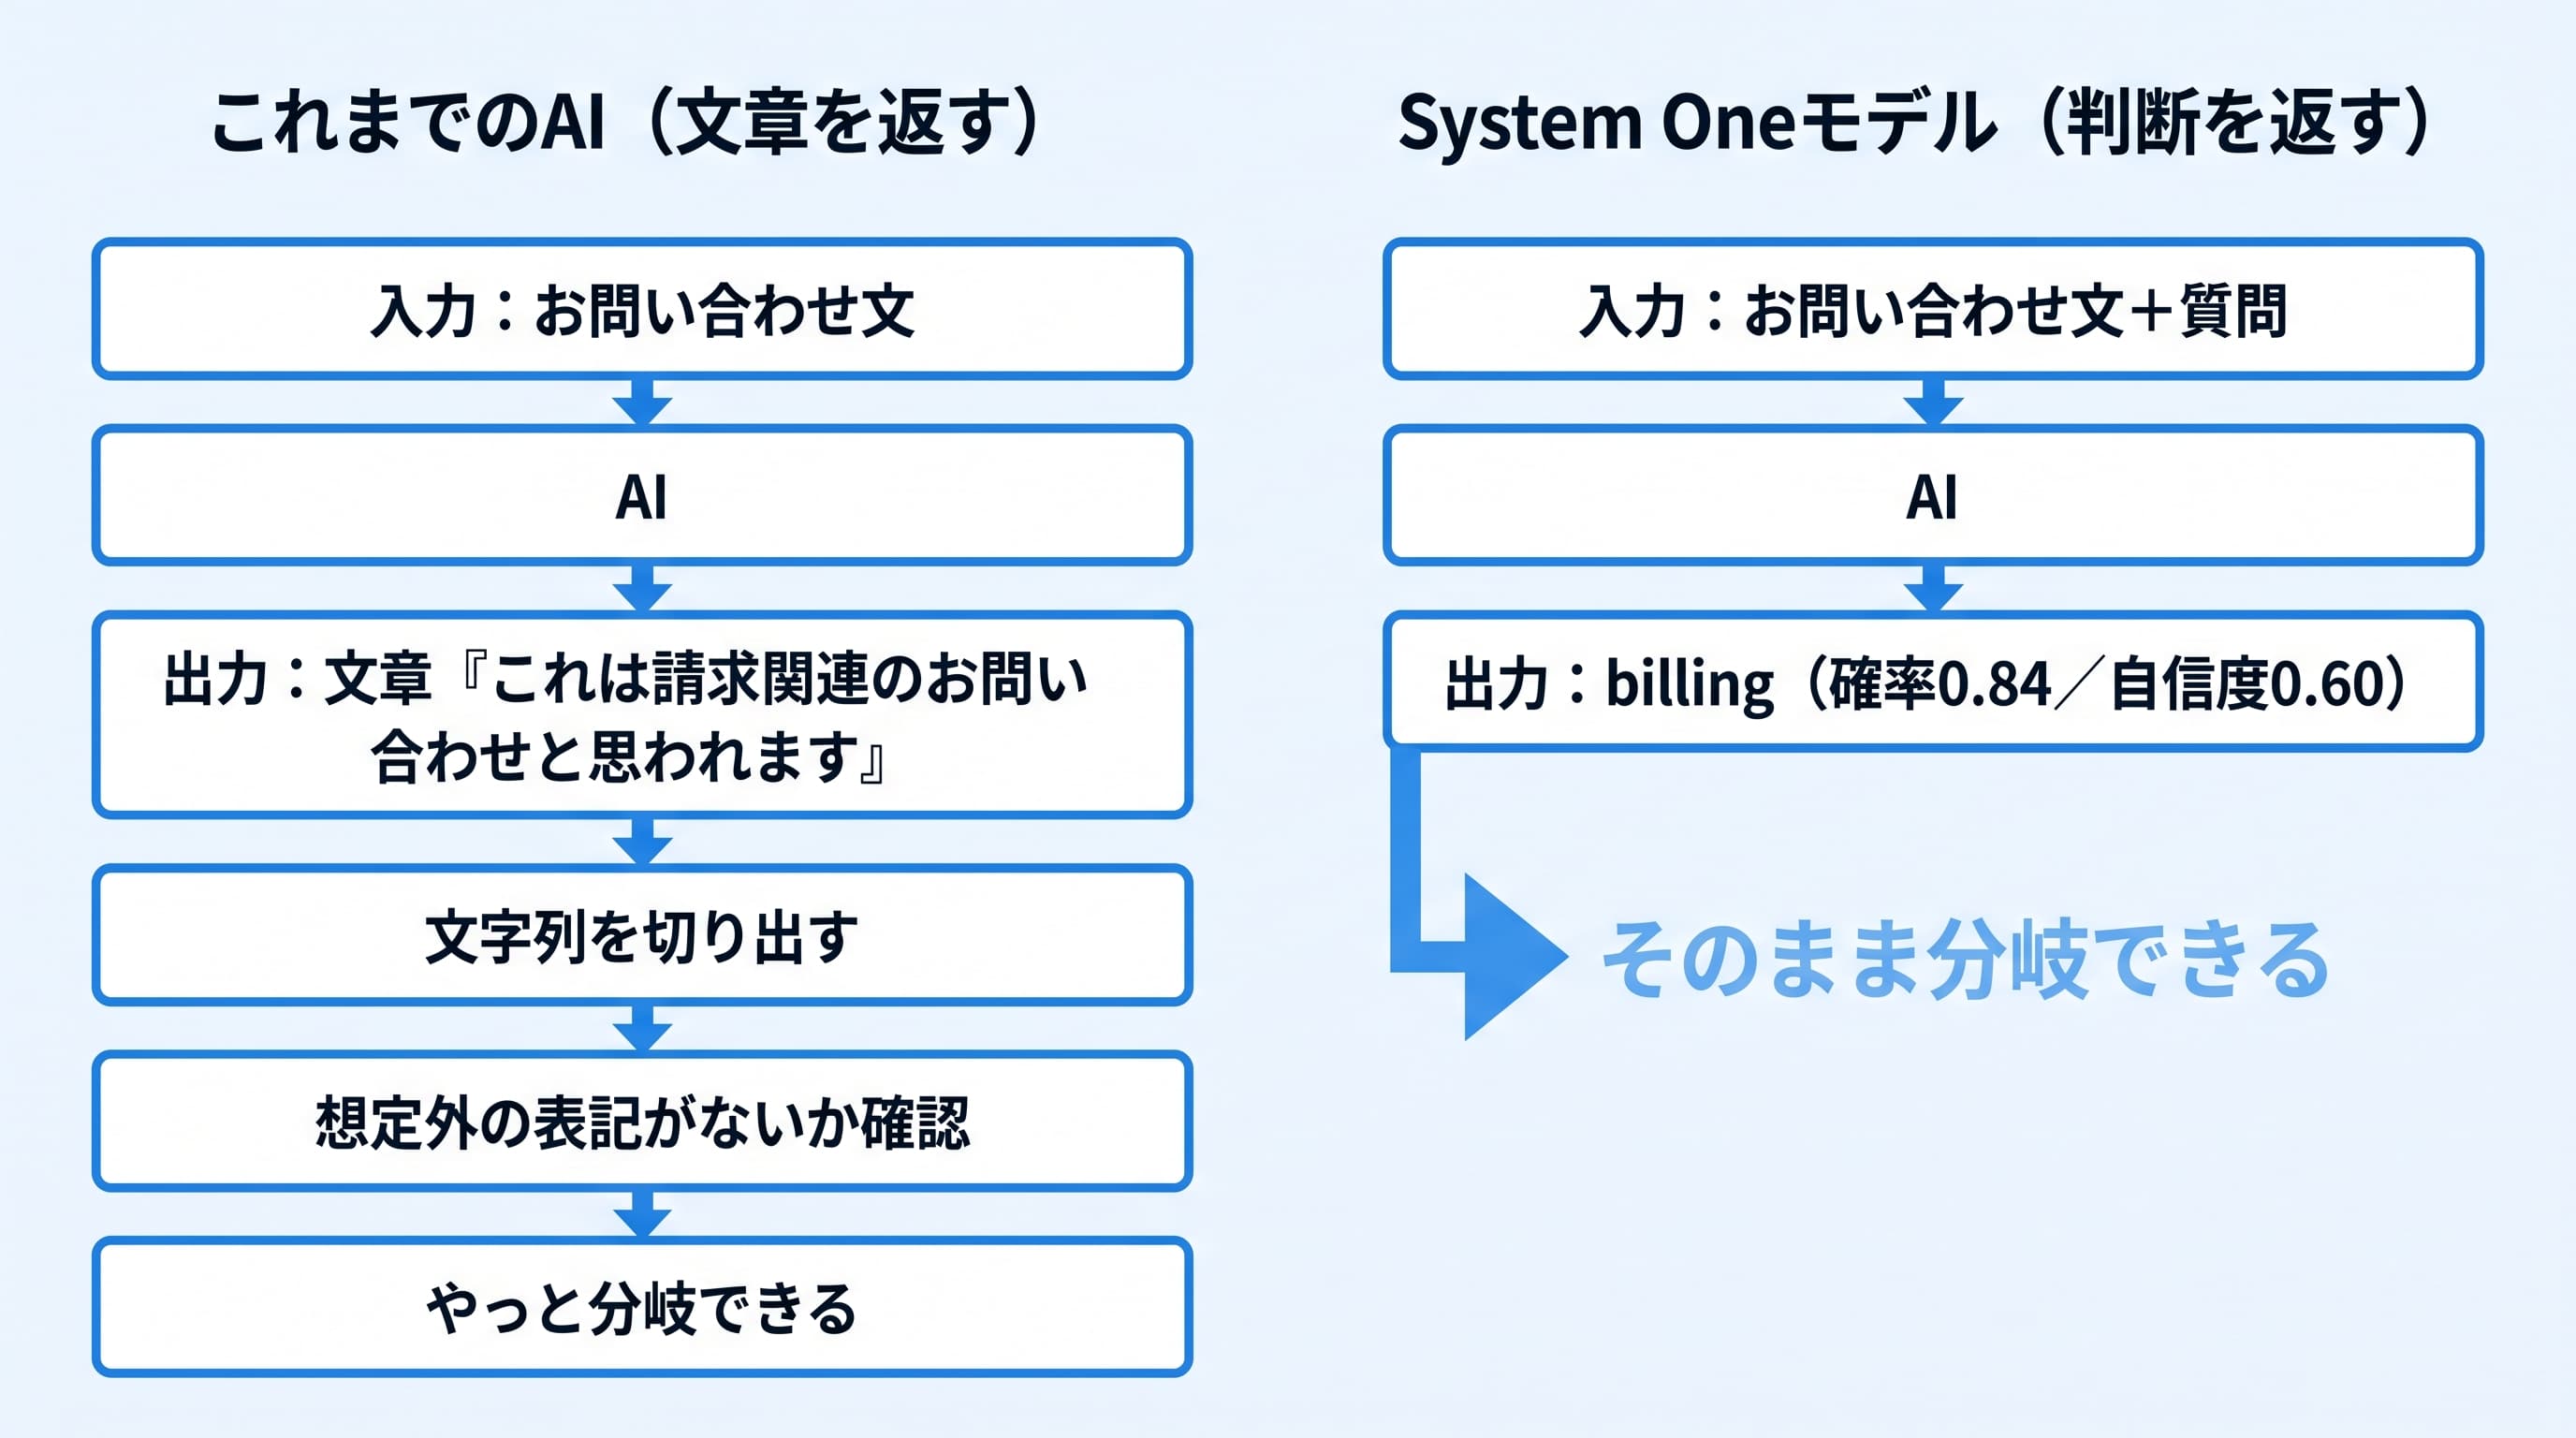
ChatGPTに「この問い合わせはどの部署宛?」と聞くと「これは請求関連のお問い合わせと思われます」といった文章が返ります。分岐に使うには、文字列を切り出し、想定外の表記がないか確かめる工程が要る。Jevはその工程ごと省きます。判断材料のテキスト(公式はstateと呼びます)と、型・指示・選択肢を書いた質問を送ると、こう返ってきます。
// 返ってくるのは文章ではなく、この形
{ "choice": "billing",
  "probabilities": { "billing": 0.84, "technical": 0.159, "sales": 0.001 },
  "confidence": 0.596 }
返ってくるのは"billing"という値そのものなので、そのままif文の条件に入れられます。
投げられる質問は3種類だけです。選択肢から1つ選ぶ「Choice」、尺度の上で点数をつける「Score」、はい・いいえの確率を返す「Noul」。1回のリクエストに混ぜて複数入れられ、すべて同じstateに対して並列に評価されるため、質問を増やしても応答時間はほとんど変わりません。
料金・速度・制限
現行モデルはjev-1.13.0。Modelsページの数値です。
| 項目 | jev-1.13 |
|---|
| 入力料金 | $0.042 / 100万トークン($42 / 10億トークン) |
| 出力料金 | 無料 |
| 応答時間 | 70〜500ミリ秒(エンドツーエンド) |
| レート制限 | 毎秒25万トークン / 毎分1,200リクエスト |
| コンテキスト長 | 64,000トークン(stateと最長の質問で32,000) |
| 入力形式 | テキストのみ(画像・音声・動画は非対応) |
公式ブログのDoomデモが分かりやすい例です。ゲームの状態を毎秒10回投げて操作を決めさせ、1時間あたり約7ドル。
LLMと何が違うのか — 公式evalの数字を読む
精度は互角、コストは76分の1
TypeSafeは専用のeval(評価)サイトを公開しています。セキュリティインシデント対応・トレース分析・請求書処理・カスタマーサービスの4業務を各モデルに同じ設計で解かせたもの。正解ラベルはGPT-6 Astra と Claude Fable 5.1 の予測の平均です。
| モデル | 正解率 | 1件あたりコスト | 1件あたり所要時間 |
|---|
| Jev | 67.8% | $0.0004 | 0.4秒 |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1秒 |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3秒 |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8秒 |
| Claude Sonnet 5 | 67.8% | $0.1174 | 78.1秒 |
正解率がほぼ並ぶGPT-5.6 Terraと比べて、コストは約76分の1、時間は約25分の1。Claude Opus 5とならコストは約440分の1です。公式トップページの「193.6倍速い、444.6倍安い」も、この4ワークフローの数字だと明記されています。
型が壊れない
もうひとつの違いが型安全です。出力できる値の集合を先に決めて渡すので、スキーマに合わない値は返りません。公式は「数学的に不可能だ」と書いています。ただし壊れないのは形式で、答えが常に正しいわけではない。返ってこないのは"bulling"のような存在しない値や、途中で切れたJSONです。
賢さで上回ったわけではない
表のとおり、GPT-5.6 Sol の74.1%、Claude Opus 5 の73.1%に対してJevは67.8%。数ポイント負けています。しかもこのevalはTypeSafe自身が設計して自社で走らせたもので、「OpenAIとAnthropicのモデルに有利に働く」と公式ブログが自分から注記しています。公開ベンチマークのスコアも出さない方針で、「たとえ自分が勝っていてもベンチマークを強調するな」と書く会社は珍しいと思います。
つまりJevはLLMを賢さで置き換えるものではなく、同じ精度でよい判断を2桁安く2桁速く回すためのもの。どの作業をどちらに振るかを決めるのは、モデルではなく作る側の仕事です。
AI時代のアプリ開発コース
ShiftBのAIシフトコースは、Claude Codeで本格的なWebアプリケーションを作りながらAI駆動開発を身につけるコースです。ただ作って終わりではなく、コードを読め、セキュリティに責任を持って提案でき、要件定義などの上流工程まで担えるところまで現役エンジニアがサポートします。
AIシフトコースを見る →Jevが使えなくても今日から効く「分解して聞く」設計
同じモデルでも、1発で聞くより分解した方が精度が上がる
evalサイトで、Jevの数字より驚いたのがこちらです。TypeSafeは各モデルを2通りで測っています。方針を丸ごと渡して一発で答えさせる「prompt」と、判断を細かい質問に割ってコードで組み立てる「workflow」。違うのは聞き方だけ。
- Claude Opus 5:64.8% → 73.1%
- Claude Sonnet 5:60.4% → 67.8%
- GPT-5.6 Sol:63.4% → 74.1%
- Claude Haiku 4.5:18.1% → 53.6%
安くなり、速くもなります。Opus 5 は1件$0.3417・70.5秒から$0.1761・37.8秒へ。4つのタスク平均で、どのモデルも同じ方針をプロンプトで渡すよりワークフローにした方が正確で、安く、速いとevalサイトは結論づけています。手元のモデルにそのまま効きます。
経費精算の例で見る「モデルが答え、コードが決める」
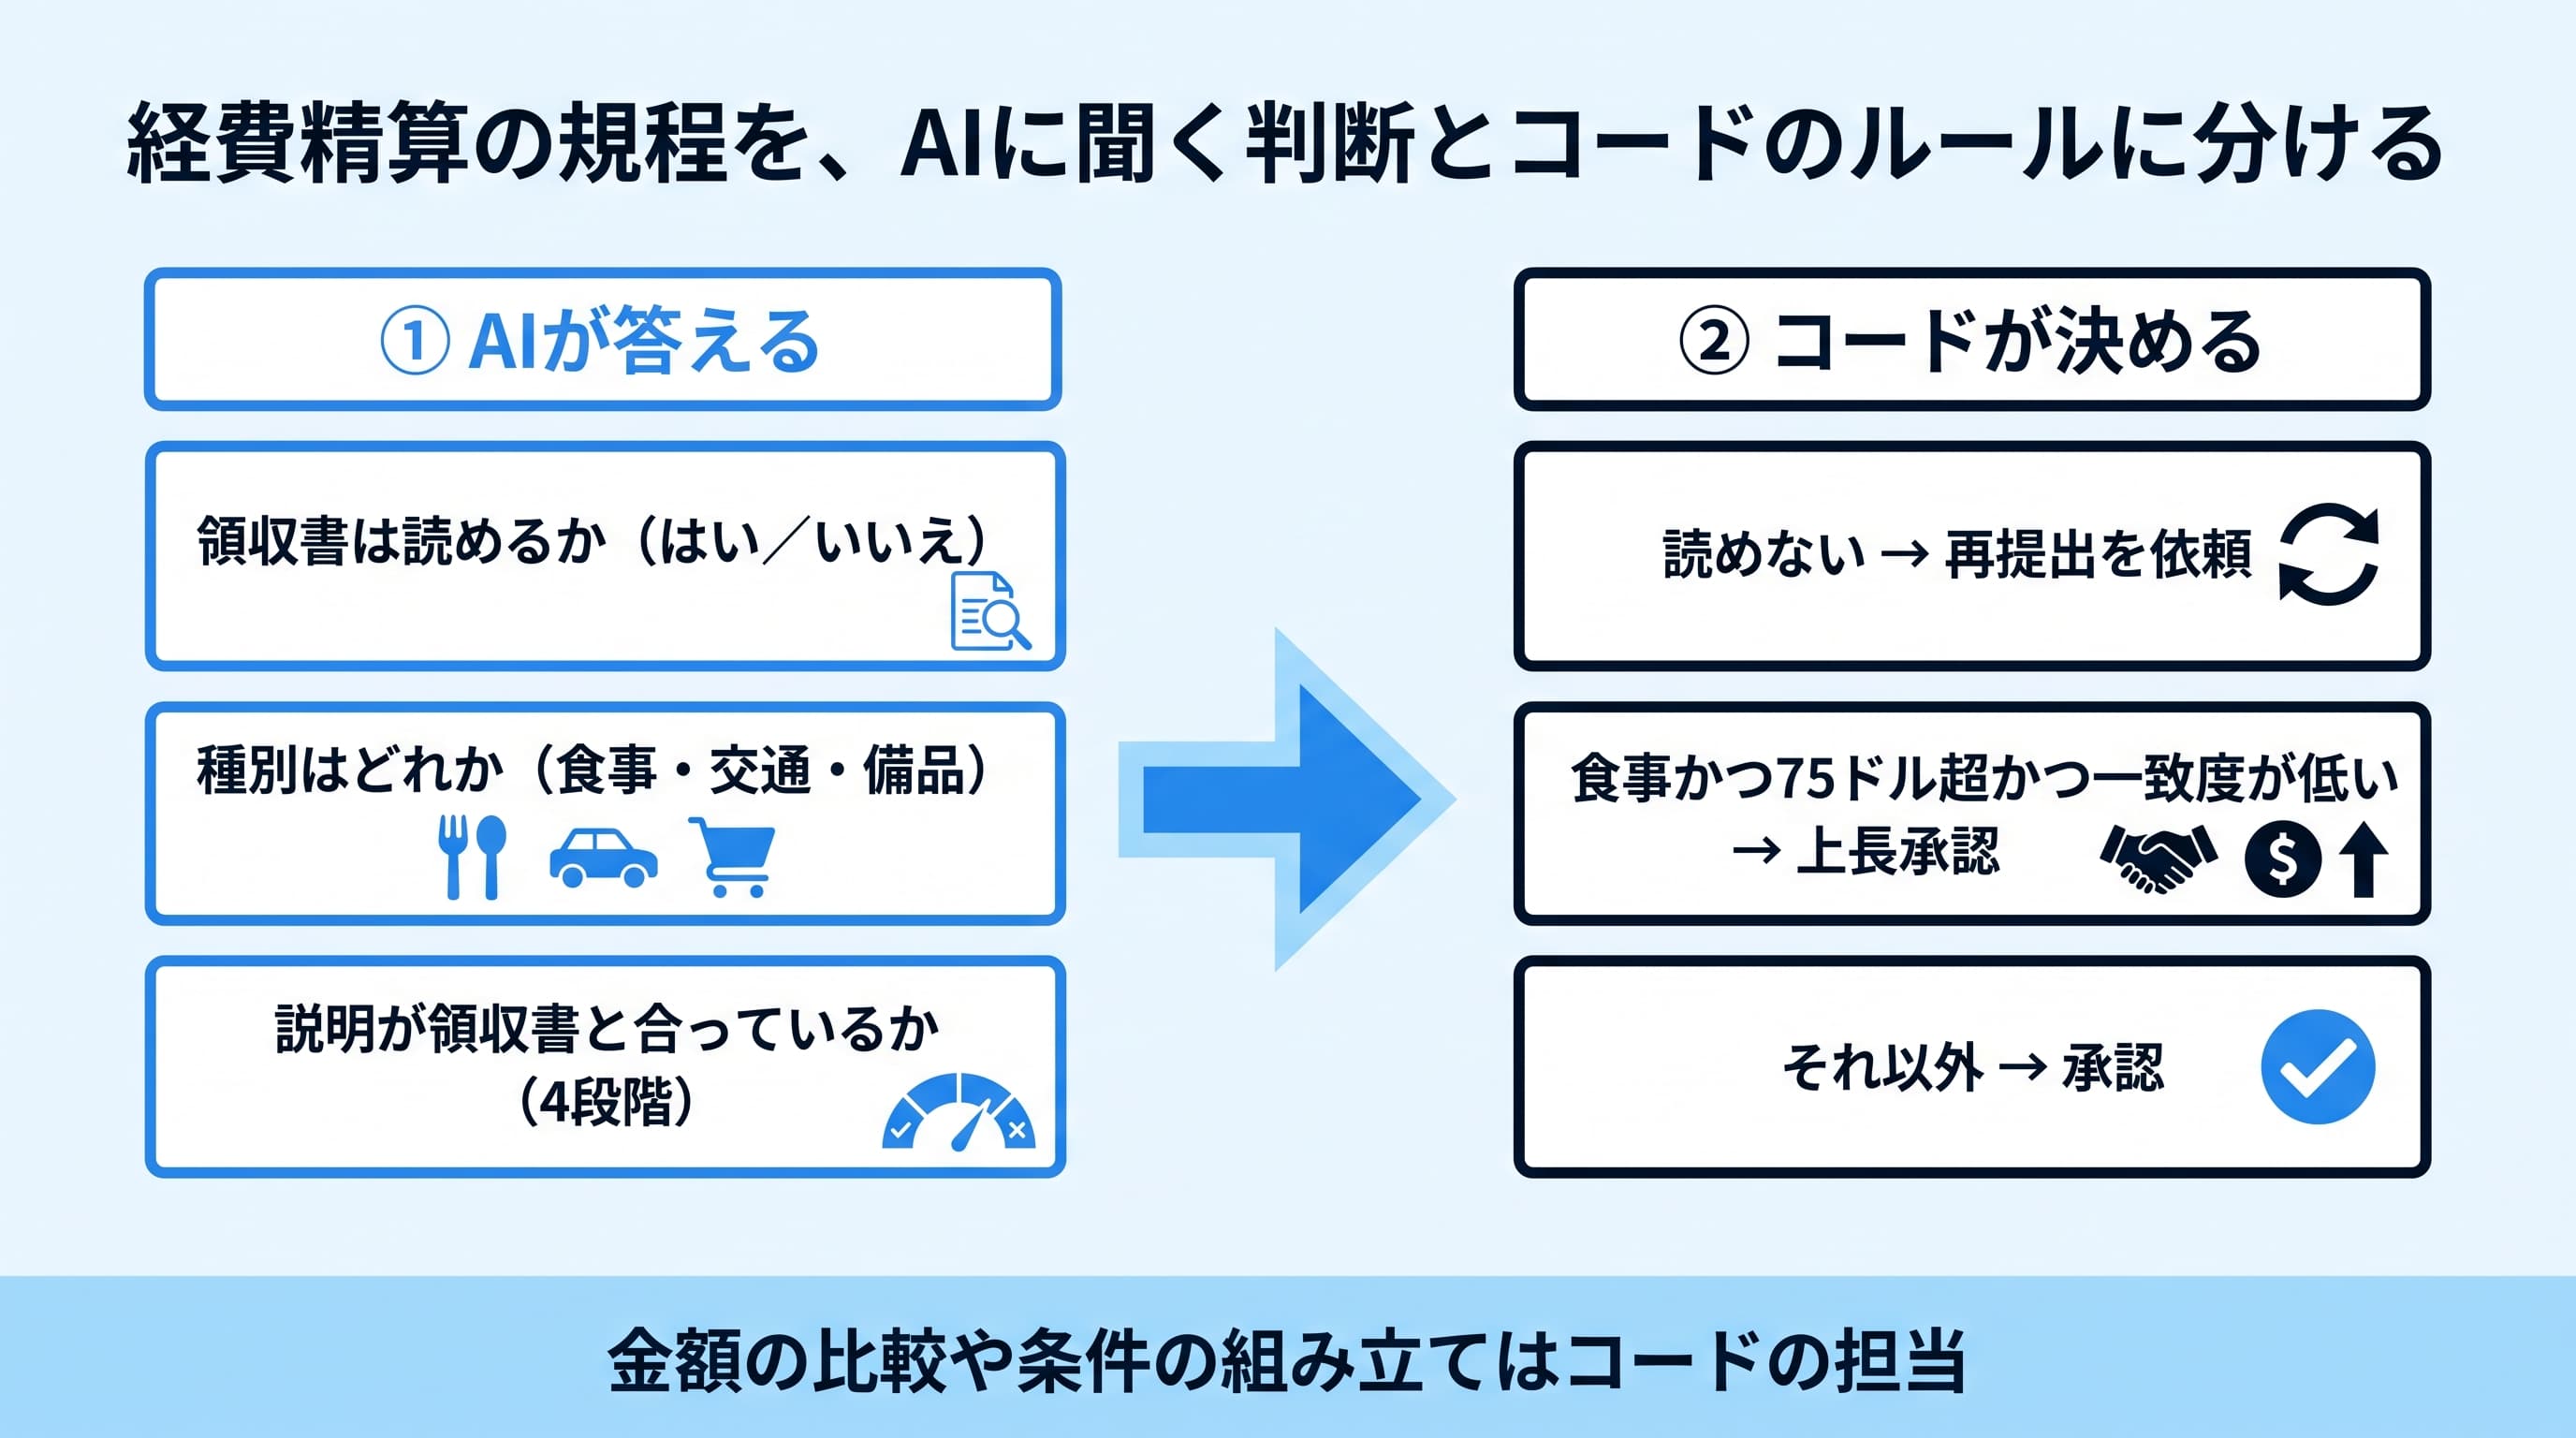
evalサイトの経費精算の例を借ります。規程は「領収書が読めなければ再提出。種別を食事・交通・備品に判定。食事で75ドル超、かつ説明が領収書と合わなければ上長承認。それ以外は承認」。
悪い例は、この規程をそのまま貼って「承認していいか判断して」と聞くやり方。金額の比較も解釈も最終判断も全部モデルの中で起きるので、どこで間違えたのかを後から追えません。
良い例は、1文ずつを質問かルールに振り分けます。
- モデルに聞く:領収書は読めるか(Noul)/種別はどれか(Choice)/説明が領収書とどれくらい一致しているか、4段階で(Score)
- コードが決める:読めなければ再提出。食事かつ75ドル超かつ一致度が低ければ上長承認。それ以外は承認
75ドルの比較はコードの担当で、モデルがやるのは人間なら数秒で答えられる判断だけ。規程が80ドルに変わっても、数字を1つ変えれば済みます。
自信度でしきい値を切る
ChoiceとScoreの答えにはconfidenceという0〜1の値が付きます。公式ドキュメントは3段階に分ける設計を勧めています。高ければ自動で処理、中くらいなら確認を挟む、低ければ人に回す。コード例はしきい値を操作の重さで変えていて、0.5未満は人に回し、残高照会のような取り返しのつく操作はそのまま実行、送金の承認は0.9を超えなければ確認を取る。AIを業務に載せられるかの分かれ目は、賢さより「自信がないときの行き先を決めてあるか」だと僕は思っています。
自分の仕事の判断を切り出す4ステップ
4つの手順
- 「書かせている作業」と「決めさせている作業」を分ける。分類・振り分け・要否判定は判断、返信文の作成は生成です。問い合わせ対応なら「どの部署か」は判断で「返信文」は生成なので、先に切ります。
- 判断を1問ずつに割る。「この問い合わせを処理して」ではなく「緊急か」「どの部署か」「どれくらい怒っているか」に割る。公式も「長い推論が必要な質問や、独立した複数の要素を天秤にかける質問は分解しろ」と書いています。1問に詰め込んだまま精度が出ないと嘆くのが、いちばん多いつまずき方です。
- 答えの選択肢を先に書き出す。つまずくのは「該当なし」を用意し忘れること。これがないとモデルは無理にどれかへ寄せます。公式の日付抽出ガイドでも、欠けている情報は推測ではなく報告させろと書かれています。
- 自信度のしきい値と、外れたときの行き先を決める。いちばん後回しにされるのがここです。前掲のInfoWorldでも、HyperFrame Researchのアナリストが「質問・出力・しきい値・エスカレーション先を事前に決める必要があり、それ自体が相当な作業になりうる」と指摘しています。
使う前に知っておくべき限界
TypeSafeは「jaggedness(ギザギザ)」というページで失敗モードを9つ自分から公開しています(2026年9月17日時点)。日本から使う人に効くのはこのあたりです。
- 日本語は英語ほどではない。Modelsページに「英語が主要な学習言語で、精度が最も良いのも英語。CJKを含む他の言語も同等ではない。頼る前に自分のコンテンツでテストすること」と明記されています
- 計算とカウントが苦手。「Jevは電卓ではない」。金額の比較も件数の集計もコード側でやる前提です
- 日付の前後比較が苦手。日付を順序のある量ではなくテキストとして読むため、抽出だけさせて比較はコードでやる形が推奨されています
- stateに関係ない情報を詰めると精度が落ちる。敵対的な入力として扱う設計にもなっておらず、誘導するテキストが混ざると答えが動きうるとも書かれています
いま試すなら — ウェイトリストと、Vercel AI Gateway
TypeSafe本家は早期アクセス中で、公式サイトのウェイトリストから順次開放されています。プレイグラウンド、Python版とJavaScript版のSDK、POST /v1/systemoneのHTTP APIが用意されています。
ただ、順番待ちをしなくても触れる経路があります。Vercel AI Gateway(複数のAIモデルを1つの窓口から呼べるサービス)のモデル一覧https://ai-gateway.vercel.sh/v1/modelsを認証なしで取得すると、typesafe-ai/jevが登録されていました。種別はevaluation、入力はテキストのみ、価格は1トークンあたり$0.000000042、出力は0。学習に使わない設定とゼロデータ保持も付いています。ただしホスティングは1リージョンのみとInfoWorldが報じ、レート制限も「予告なく変わりうる」と公式が明記しているので、まず小さく試すところからです。
分解の粒度、選択肢の切り方、しきい値の置き方。この4ステップは読んで理解するまでは簡単で、難しいのは自分の業務で一度通し切るところです。どこまでをコードで書き、どこからをAIに聞くのかは、誰かに壁打ちしながら一度組んでみないと感覚が掴めません。
AI時代のアプリ開発コース
ShiftBのAIシフトコースは、Claude Codeで本格的なWebアプリケーションを作りながらAI駆動開発を身につけるコースです。ただ作って終わりではなく、コードを読め、セキュリティに責任を持って提案でき、要件定義などの上流工程まで担えるところまで現役エンジニアがサポートします。
AIシフトコースを見る →まとめ — 文章を書かせる仕事と、決めさせる仕事を分ける
Jevは、LLMの置き換えではなく分担の提案です。精度はフロンティアモデルに数ポイント届かない一方、1件あたり$0.0004・0.4秒という数字は、これまで「AIを挟むほどではない」と諦めていた粒度の処理を現実的にします。
そしてJevを触れない今日からできることがあります。自分の業務で「AIに決めさせている作業」を1つ選び、1発のプロンプトから、分解した質問とコードの組み合わせに書き換えてみることです。最初の1つを組み替えたかどうかで、次に何を学べばいいかの解像度が変わります。手を動かす順番は、Claude Codeで業務アプリを作る手順や仕様駆動開発(SDD)入門も合わせて読んでみてください。
COURSE
AI時代のアプリ開発コース
ShiftBのAIシフトコースは、Claude Codeで本格的なWebアプリケーションを作りながら学ぶコースです。コードを読め、セキュリティに責任を持って提案でき、要件定義などの上流工程まで担える状態を目指します。まずは無料相談会でご相談ください。